Tabla de contenidos
Open Tabla de contenidos
Introducción
Si estás construyendo productos de IA, inference engineering se vuelve relevante mucho antes de lo que la mayoría espera. Al principio el foco suele estar en la calidad del modelo, los prompts y las demos. Pero cuando algo empieza a ser un producto de verdad, aparecen otras preguntas:
- ¿Por qué el primer token es lento?
- ¿Por qué la longitud del prompt de pronto cambia la experiencia de uso?
- ¿Por qué una opción de deployment se ve barata en un prototipo y cara en producción?
- ¿Por qué un modelo funciona bien en un entorno y falla en otro?
- ¿Qué deberían medir, de verdad, producto e ingeniería?
Esas son preguntas de inference engineering. Esta es una nota práctica de PM. La meta es entender qué pasa detrás de escena cuando llamas a un LLM (es decir, inference) y cómo tomar mejores decisiones de producto y de plataforma, con el respaldo de un experimento simple de Gemma 4 12B en una instancia de GPU T4 de Google Colab.
Recorrido en YouTube
¿Qué es inference engineering?
A alto nivel, inference engineering es la disciplina de servir modelos bien en productos reales.
Un LLM no es un servicio web normal. Cuando alguien envía un prompt, el sistema tiene que cargar los pesos del modelo, procesar los tokens de entrada, construir el estado de attention, guardar la KV cache y generar la salida de a un token. Por eso la inferencia no es solo un problema de infraestructura. También es un problema de producto y de negocio.
Por qué debería importarle a un PM técnico
Hay tres razones prácticas.
1. Afecta directo la experiencia de producto
La gente no vive tu modelo como un benchmark. Lo vive como respuesta, confiabilidad y calidad bajo restricciones.
Si el primer token es lento, el producto se siente lento. Si los prompts son demasiado grandes, sube el costo y empeora la latencia. Si el hardware no encaja con la carga, se rompe la economía unitaria. Inference engineering está justo en ese ciclo.
2. Cambia las decisiones de modelo y de plataforma
Los modelos abiertos van a jugar un papel parecido al del software open source. No van a reemplazar cada modelo cerrado, pero van a importar en el stack. Eso convierte los tradeoffs de serving en un juicio de producto, no solo de ingeniería.
3. La mayoría de los productos reales van a ser multi-modelo
El modelo correcto depende de la tarea y del entorno.
Un modelo liviano en un teléfono, un modelo de código más fuerte en una laptop, un modelo más grande en producción y otro en un dispositivo edge pueden convivir en la misma arquitectura.
Eso significa que los equipos tienen que entender cómo cambia la inferencia según el hardware, el presupuesto de memoria, la longitud de contexto y los requisitos de latencia.
Qué ocurre durante la inferencia
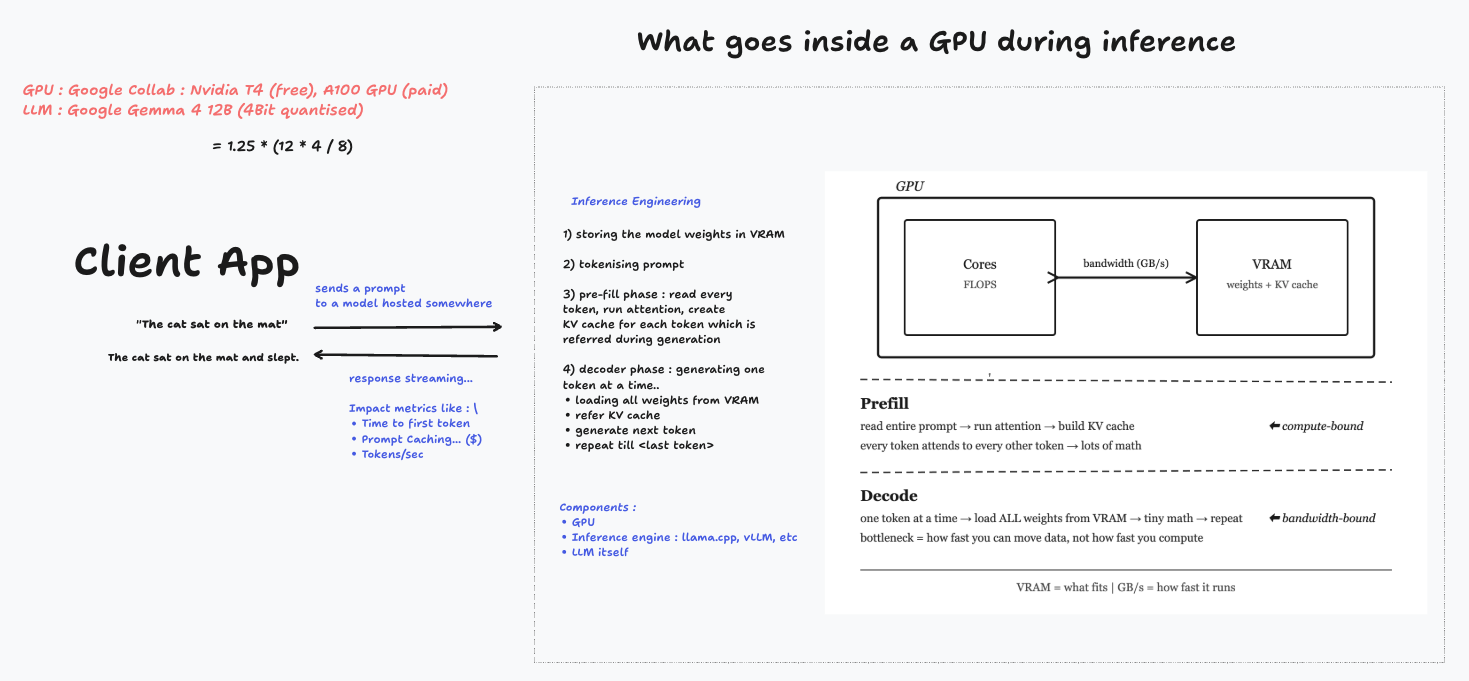
Una forma clara de pensarlo:
- Un cliente envía un prompt.
- El prompt se tokeniza.
- Los pesos del modelo se leen desde la VRAM.
- El sistema hace un paso de prefill sobre los tokens de entrada.
- El decoder empieza a generar tokens de salida, uno por uno.
La secuencia es simple, pero explica mucho del comportamiento del producto.
Los pesos del modelo viven en la VRAM
Una fracción grande de la memoria de la GPU se va solo en guardar el modelo.
En este experimento usé Gemma 3 12B con cuantización de 4 bits. Una estimación aproximada pone los pesos del modelo alrededor de 6 GB, y el uso real queda un poco más arriba cuando entran el overhead del runtime y los metadatos de la cuantización.
Esa estimación sirve aunque no implementes el stack tú mismo. Te ayuda a juzgar rápido si un camino de deployment es plausible.
Prefill y decode son fases distintas
Esta es una de las ideas más útiles de inference engineering.
La fase de prefill procesa el prompt de entrada. Cada token de entrada suma cómputo de attention y a la key-value cache que se guarda para reutilizarla después.
La fase de decode es lo que la mayoría experimenta como generación. Predice un token a la vez, después de que termina el prefill.
Estas fases estresan el sistema de forma distinta:
- El prefill depende mucho de la longitud del prompt y del cómputo.
- La velocidad de decode está más atada a la dinámica de generar token por token y al movimiento de memoria.
Por eso «el modelo se siente rápido» no es una sola métrica.
Los tres recursos prácticos a vigilar
Si quieres una vista operativa compacta, yo vigilaría estos tres:
VRAM: ¿caben el modelo y su estado de runtime?Compute: ¿qué tan rápido puede el sistema procesar el prompt, sobre todo durante el prefill?Memory bandwidth: ¿con qué eficiencia puede el sistema mover datos durante la generación?
No son solo métricas de ingeniería. Definen si el producto es viable.
Si la VRAM no alcanza, el modelo no entra bien. Si el cómputo es débil, el prefill se vuelve lento y sube la latencia del primer token. Si el ancho de banda está limitado, sufre el throughput de generación.
La KV cache no es un detalle lateral
La KV cache es central para que la inferencia funcione de forma eficiente.
Cuando el modelo procesa los tokens de entrada, guarda estado relacionado con attention en la memoria de la GPU. Esa cache crece con la longitud del prompt, y esa es una razón por la que las cargas de contexto largo se vuelven caras o lentas.
También explica por qué el prompt caching importa en producción. Si un prefijo compartido se reutiliza entre requests, el sistema puede evitar recomputar el mismo trabajo, y mejoran la latencia y el costo.
El experimento práctico: Gemma 3 12B en una GPU T4 de Google Colab
La segunda mitad de la sesión pasó de la teoría a un experimento simple. Usé una GPU Tesla T4 gratuita en Google Colab y cargué un modelo Gemma 3 12B cuantizado a 4 bits a través del stack de Hugging Face.
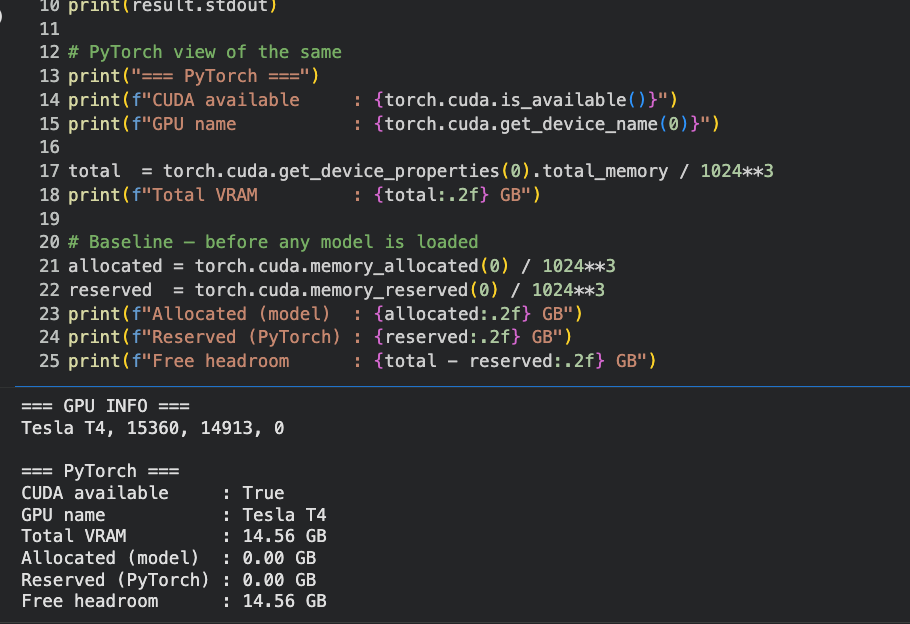
El setup ayudó a responder preguntas concretas que a un PM le deberían importar:
- ¿Cuánta VRAM se consume antes de que llegue tráfico real?
- ¿Cómo se ve el time to first token en una GPU modesta?
- ¿Cuántos tokens por segundo obtenemos después de que empieza la generación?
- ¿Qué cambia cuando crece la longitud del prompt?
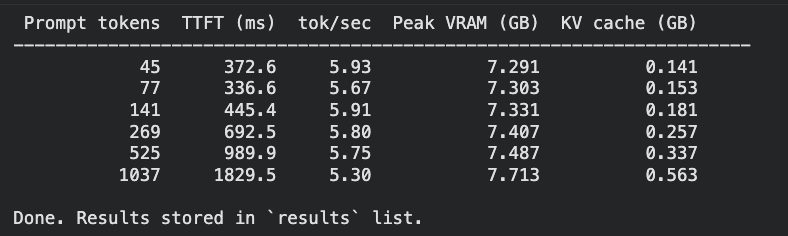
Los números fueron claros en la dirección:
- El modelo ocupó más o menos la mitad de la VRAM disponible de la T4 después de cargarlo.
- El time to first token fue claramente sensible a la longitud del prompt.
- Los tokens por segundo se mantuvieron relativamente estables en comparación con el TTFT.
- La KV cache creció a medida que el prompt se alargaba.
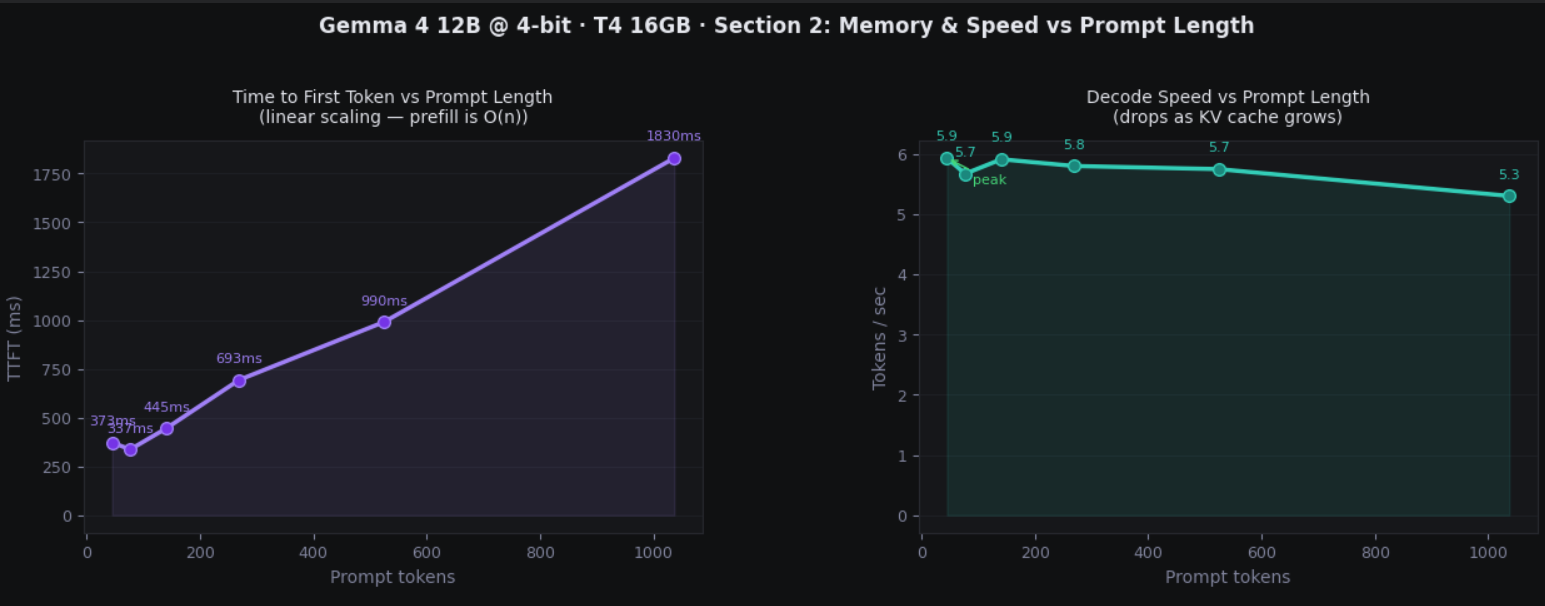
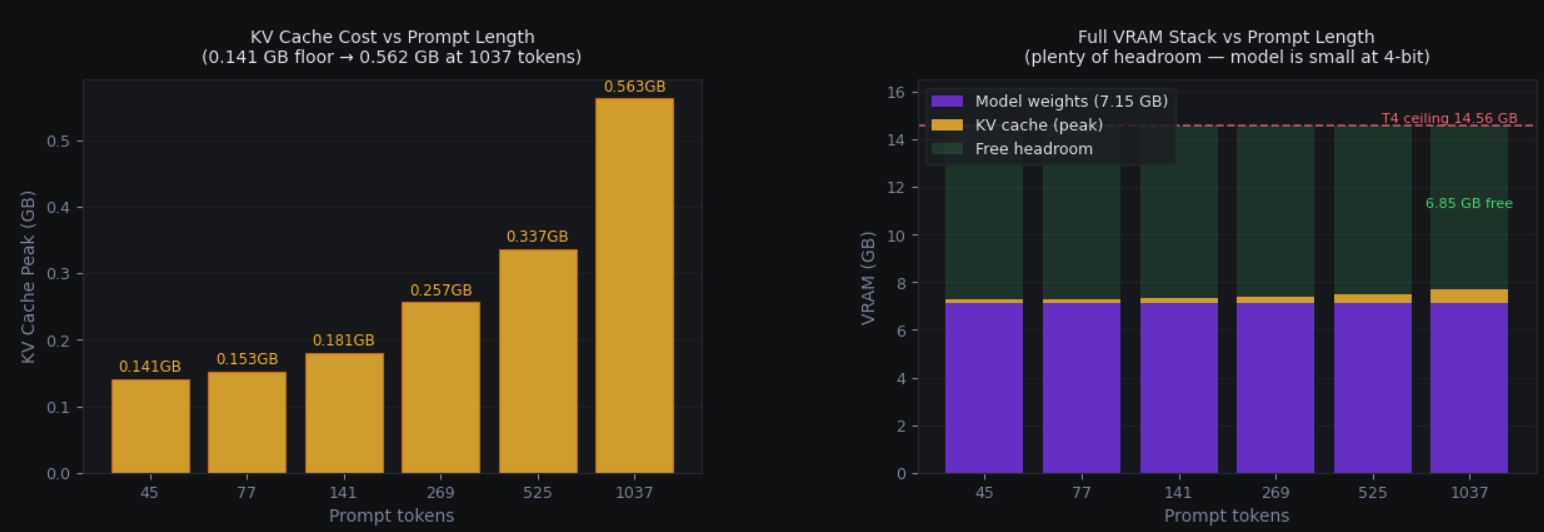
Ese es exactamente el tipo de patrón que conviene internalizar si estás tomando decisiones de roadmap o de plataforma.
Conclusiones importantes
A medida que creció la longitud del prompt, el time to first token aumentó de forma más o menos lineal, mientras que los tokens por segundo se mantuvieron relativamente planos.
Este es un ancla útil para un PM. Nos dice:
- Los prompts largos dañan la respuesta antes de que empiece la generación.
- Optimizar el prompt no es solo ahorrar tokens: es reducir el costo del prefill.
- La latencia que percibe quien usa el producto suele venir de más atrás en el pipeline de lo que se asume.
Si estás construyendo una función con un LLM, esto tiene consecuencias inmediatas de producto. Un sistema puede sentirse lento aunque la velocidad de decode sea aceptable, simplemente porque el prompt hace demasiado trabajo al inicio.
Una checklist simple para PMs técnicos
Cuando miro ahora una carga de trabajo de LLM, intento preguntar:
- ¿Qué modelo estamos sirviendo?
- ¿En qué hardware?
- ¿Qué precisión estamos usando?
- ¿Qué tan grandes son los prompts?
- ¿Cuánto crecimiento de KV cache deberíamos esperar?
- ¿El cuello de botella es prefill, decode o que el modelo quepa en memoria?
- ¿El prompt caching o un cambio de arquitectura pueden reducir el desperdicio?
Ese conjunto de preguntas te acerca mucho más a entender de verdad que un genérico «el modelo se siente lento».
También lleva a mejores conversaciones con ingeniería. En lugar de pedir solo scores de eval, empiezas a preguntar:
- ¿Cuál es nuestro time to first token?
- ¿Cómo cambia con la longitud de contexto?
- ¿Cuál es nuestro throughput efectivo?
- ¿Qué está empujando más el costo ahora mismo?
- ¿Qué parte del stack es, de verdad, el cuello de botella?